Pular para o conteúdo

apps/resiliency/health-check

108 · Resiliência & Tolerância a Falhas · ≈ 6 min de estudo

Health Check

Expõe o estado do serviço em probes separados, cada um respondendo a uma pergunta do orquestrador: /live (o processo travou?), /startup (terminou de subir?), /ready (pode receber tráfego agora?) e /health (como estão todas as dependências?). Separar as perguntas evita reiniciar um processo saudável por causa de uma dependência lenta, e mandar tráfego a uma instância sem banco.

passos
6
arquivos
6
testes
0
tecnologias
5
Infraestrutura realTypeScriptBunElysiaPostgreSQLDocker
Baixar cartão

Cenário

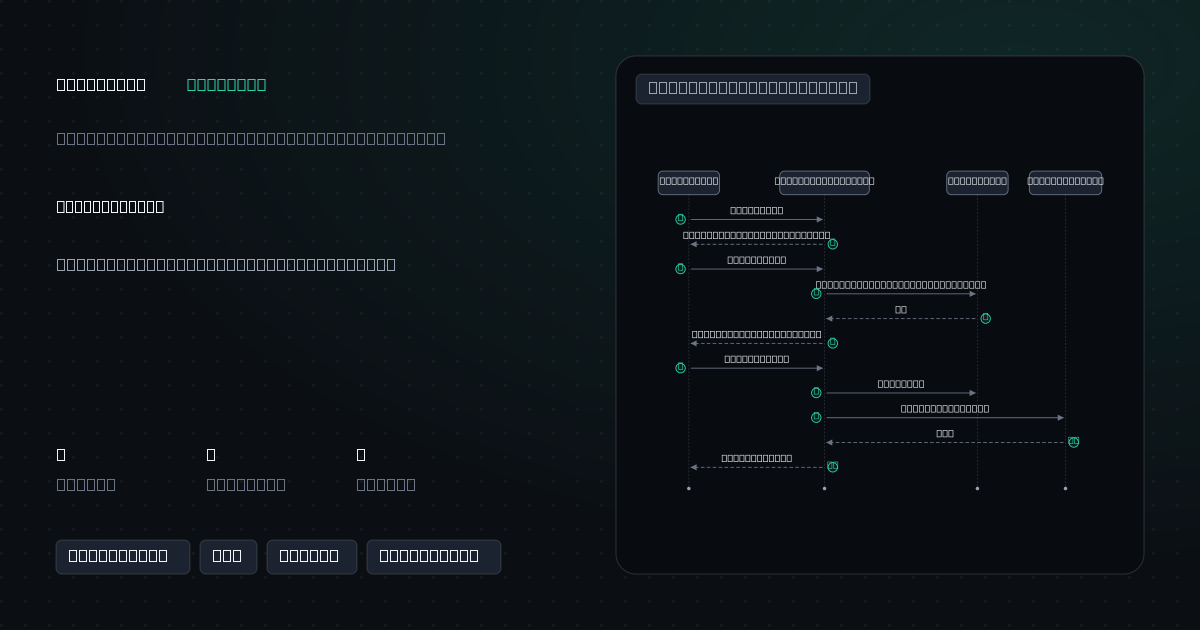
A API de pagamentos depende do PostgreSQL (crítico: sem saldo não há pagamento) e do gateway SPI do BACEN (degradado: sem ele o PIX vai para fila). Com o BACEN fora, /health responde 207 e a instância continua no balanceamento. Com o pool do banco esgotado por um lock, /ready responde 503 em 1 s e a instância sai do balanceamento — mas /live segue 200 e o processo não é reiniciado à toa.

Planta

Sequência
11/11
GET /live1200 sem tocar dependência2GET /ready3SELECT 1 (timeout 1 s, cache)4ok5200 só com as críticas6GET /health7SELECT 18GET /spi/status950310207 degraded11KubernetesAPI de pagamentosPostgreSQLGateway BACEN
11

11 passos — reproduza para seguir o fluxo

  1. 01

    Cada check declara critical, timeoutMs e run, reusando o pool e fazendo fetch com sinal — nunca abre conexão própria

  2. 02

    /live responde sem tocar dependência; /startup responde 503 até o boot terminar

  3. 03

    /ready roda só os checks críticos; /health roda todos

  4. 04

    Cada check corre contra o próprio timeout: dependência travada vira critical ou degraded sem travar o probe

  5. 05

    healthAggregate: algum critical → 503; senão algum degraded → 207; senão 200

  6. 06

    O resultado de cada check fica em cache por cacheTtlMs: probes frequentes não viram uma query por chamada

Trade-offs

O que se ganha, o que se paga

3 vantagenscada ganho tem um preço3 custos

Vantagens

  • Cada probe leva à ação certa: reiniciar, tirar do balanceamento ou só alertar

  • Timeout por check impede que uma dependência trave o probe

  • Cache poupa a dependência já degradada

Custos

  • Quatro endpoints e a classificação de cada dependência para manter

  • Timeout do orquestrador precisa ser maior que o interno

  • O estado reportado pode estar até cacheTtlMs atrasado

apps/resiliency/health-check

6 arquivos

src/

  • probe_health.tsPlugin Elysia com /live, /startup, /ready, /health, timeout e cache por check
  • api_payments.tsAPI de pagamentos com os checks de PostgreSQL (crítico) e BACEN (degradado)
  • bacen_gateway.tsGateway SPI em ElysiaJS com saúde trocada em runtime
  • config_health.tsConfiguração validada do ambiente
  • demo.tsdemoBoot, BACEN fora e pool esgotado, com a resposta de cada probe

sql/

  • 01_schema.sqlschemaContas com saldo

Executar · com Docker

  1. ./docker.sh up# sobe PostgreSQL
  2. cp .env.example .env# variáveis de ambiente
  3. bun install# dependências
  4. bun run demo# roda o cenário
  5. bun run test# integração contra o serviço real
Requisitos
BunDocker
Sobe junto
PostgreSQL

Por que se relacionam

Teste rápido

Qual é o próximo passo depois de Health Check Pattern?

Próximo projeto · Resiliência & Tolerância a FalhasRate Limiting
Esc

↑ ↓ navegarEnter abrir191 resultados