Pular para o conteúdo

apps/observability/health-check-endpoint

127 · Observabilidade & Operações · ≈ 6 min de estudo

Health Check Endpoint

Expõe o estado de uma API e de cada dependência para quem a opera: /live e /ready para o orquestrador, /health com o detalhe por dependência, e /metrics com os mesmos dados como gauges do Prometheus para dashboard e alerta. Cada dependência é classificada — crítica derruba o /ready, opcional só degrada — e cada check tem timeout próprio e um limite de latência acima do qual passa a contar como degradado.

passos
6
arquivos
5
testes
0
tecnologias
7
Infraestrutura realTypeScriptBunElysiaPostgreSQLRedisRabbitMQDocker
Baixar cartão

Cenário

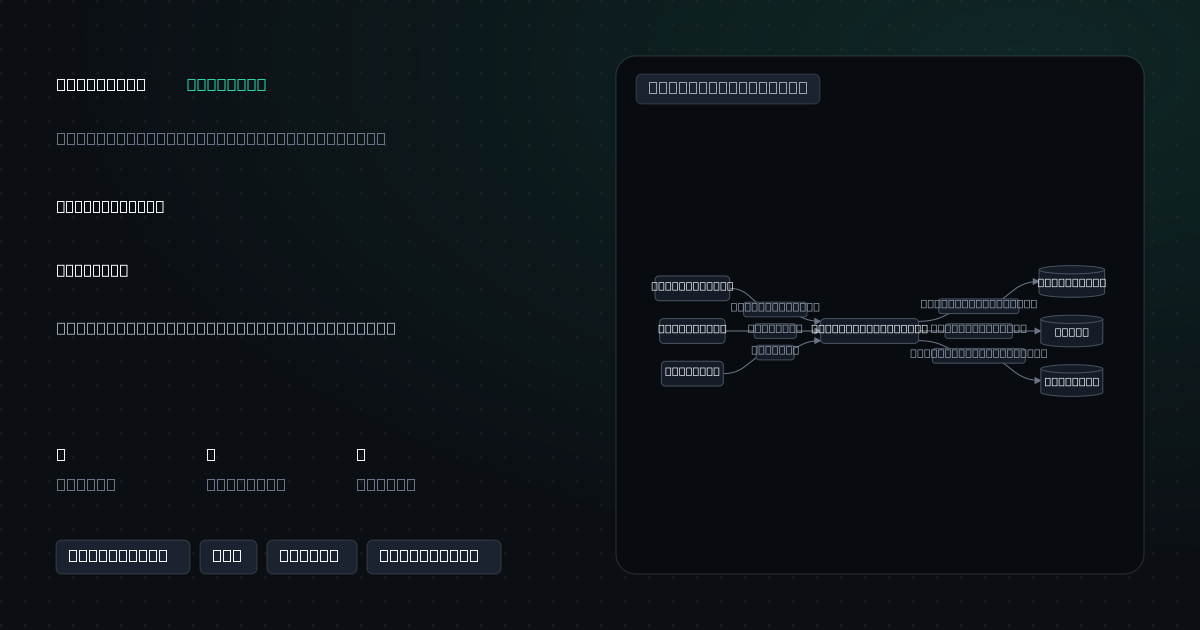
A API de pagamentos depende do PostgreSQL (sem ele não há pagamento), do Redis (cache: sem ele lê do banco) e do RabbitMQ (fila de notificações: sem ela as notificações esperam). Com o Redis fora ou a fila apagada, /health responde 207 e a instância segue no balanceamento. Com o PostgreSQL fora, /ready responde 503 e a instância sai do balanceamento, mas /live segue 200 e ela não é reiniciada. O /metrics mostra cada dependência como 1, 0,5 ou 0 e a latência de cada check.

Planta

Fluxo
6/6
OrquestradorAPI de pagamentosPrometheusOperaçãoPostgreSQLRedisRabbitMQ/live, /ready/metrics/healthSELECT 1, críticoPING, opcionalcheckQueue, opcional
6

6 passos — reproduza para seguir o fluxo

Como funciona

6 passos

Liveness e readiness por endpoint.

Esconde cada passo: lembre antes de tocar para revelar.

  1. 01

    Cada check declara critical, timeoutMs, degradedAboveMs e run, sobre conexões que a API já tem

  2. 02

    checkStatusOf: falha de check crítico é critical; qualquer outra falha, ou sucesso mais lento que degradedAboveMs, é degraded

  3. 03

    /ready roda só o PostgreSQL; /health e /metrics rodam os três; o pior status define o HTTP (200, 207 ou 503)

  4. 04

    O check do RabbitMQ usa um canal descartável na conexão existente: um checkQueue que falha fecha só esse canal, nunca o de publicação

  5. 05

    healthMetricsText publica health_check_status e health_check_latency_ms por dependência

  6. 06

    Os resultados ficam em cache por cacheTtlMs, para os probes não virarem carga sobre uma dependência já degradada

Trade-offs

O que se ganha, o que se paga

4 vantagenscada ganho tem um preço4 custos

Vantagens

  • Orquestrador, operação e Prometheus leem o mesmo estado

  • Latência alta vira sinal antes de virar falha

  • Dependência opcional fora não tira a instância do ar

  • Canal descartável isola o check do tráfego real

Custos

  • Um endpoint a mais para proteger de exposição pública

  • degradedAboveMs precisa ser calibrado por dependência

  • Classificar crítico × opcional errado derruba ou mantém a instância indevidamente

  • Um canal aberto e fechado a cada check do broker

apps/observability/health-check-endpoint

5 arquivos

src/

  • probe_health.tsPlugin com /live, /startup, /ready, /health e /metrics, timeout, limite de latência e cache
  • api_health.tsChecks de PostgreSQL, Redis e RabbitMQ sobre as conexões da API
  • config_health.tsConfiguração validada do ambiente
  • demo.tsdemoTudo no ar, Redis fora, fila apagada e PostgreSQL fora

./

  • docker-compose.ymlinfraPostgreSQL, Redis e RabbitMQ

Executar · com Docker

  1. docker compose up -d --wait# sobe PostgreSQL · Redis · RabbitMQ
  2. cp .env.example .env# variáveis de ambiente
  3. bun install# dependências
  4. bun run demo# roda o cenário
  5. bun run test# integração contra o serviço real
Requisitos
BunDocker
Sobe junto
PostgreSQLRedisRabbitMQ

Por que se relacionam

Teste rápido

Qual é o próximo passo depois de Health Check Pattern?

Próximo projeto · Observabilidade & OperaçõesMétricas, SLI, SLO e SLA
Esc

↑ ↓ navegarEnter abrir191 resultados