Pular para o conteúdo

apps/data-patterns/scheduler-agent-supervisor

098 · Dados & Persistência · ≈ 6 min de estudo

Scheduler Agent Supervisor

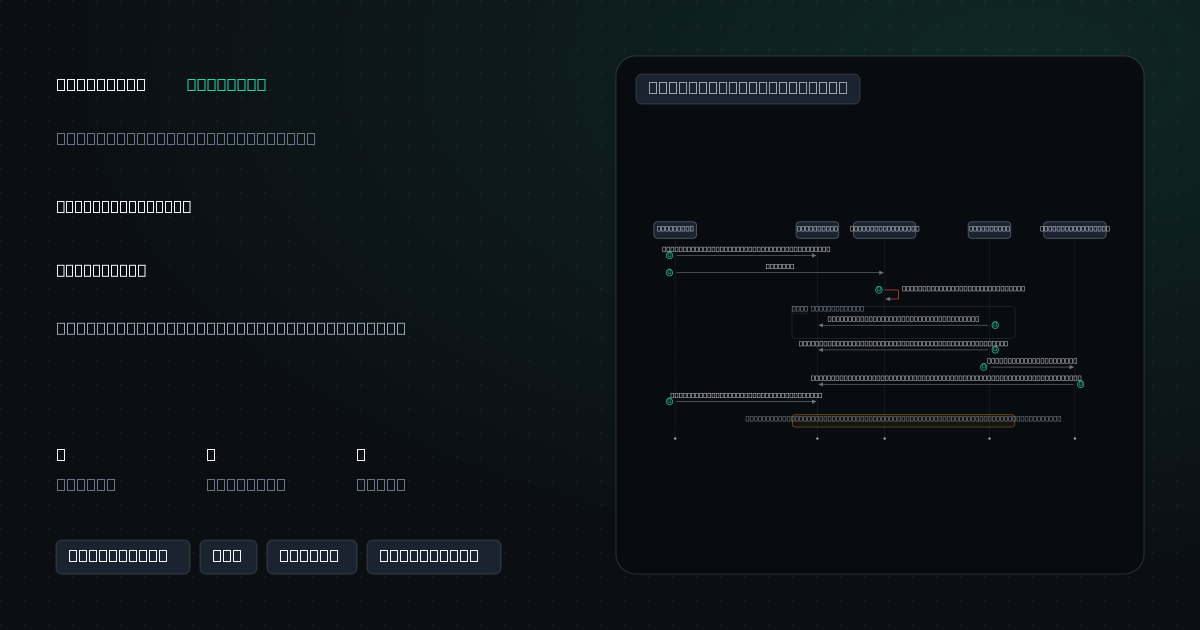
Coordena um job longo em etapas com três papéis que só conversam pelo banco: o Scheduler dispara as etapas em ordem, o Agent executa cada uma gravando heartbeat, e o Supervisor reinicia só a etapa cujo heartbeat parou. Uma etapa travada não prende o lote para sempre, e reiniciar não reprocessa o que já terminou.

passos
6
arquivos
8
teste
1
tecnologias
5
Infraestrutura realTypeScriptBunElysiaPostgreSQLDocker
Baixar cartão

Cenário

Fechamento noturno do banco em três etapas: fotografar as posições, creditar 0,5% de juros sobre saldos positivos e publicar os extratos. O processo que aplica os juros morre no meio. Reiniciar o lote inteiro fotografaria de novo e poderia creditar juros duas vezes — inaceitável com dinheiro.

Planta

Sequência
8/8
loop[a cada poll]etapa interest_apply running, tentativa 11dispara2processo morre, heartbeat para3running com heartbeat além do limiar?4UPDATE atômico: tentativa 2, recovery_log restarted5reinicia só esta etapa6efeito e conclusão na mesma transação, só se a tentativa ainda é 27vê completed, dispara a próxima etapa8passou do limite de tentativas: failed, escalated, job falha para ação humanaSchedulerPostgreSQLAgent tentativa 1SupervisorAgent tentativa 2
8

8 passos — reproduza para seguir o fluxo

Como funciona

6 passos

Agenda, executa e recupera tarefas.

Esconde cada passo: lembre antes de tocar para revelar.

  1. 01

    O Scheduler cria o job e as etapas e dispara uma de cada vez, esperando o estado durável, nunca a promise do agente

  2. 02

    O Agent atualiza heartbeat_at a cada intervalo; o efeito da etapa e o completed commitam na mesma transação

  3. 03

    O Supervisor reivindica, num único UPDATE, as etapas running com heartbeat além do limiar — dois supervisores nunca reiniciam a mesma

  4. 04

    A reivindicação incrementa attempt_count, que é o token de fencing: o agente antigo que acordar tarde não conclui, e seu efeito é desfeito

  5. 05

    Cada efeito tem chave (job_id, account_id): reexecutar uma etapa não grava nada duas vezes

  6. 06

    Além de BATCH_ATTEMPTS_MAX a etapa vira failed, o job falha e o recovery_log registra escalated

Trade-offs

O que se ganha, o que se paga

3 vantagenscada ganho tem um preço3 custos

Vantagens

  • Etapa travada é recuperada sozinha, sem reprocessar o lote

  • Papéis independentes, coordenados pelo banco

  • Trilha completa de recuperações

Custos

  • Detecção atrasa até o limiar de heartbeat

  • Toda etapa precisa ser idempotente

  • Polling constante do supervisor

apps/data-patterns/scheduler-agent-supervisor

8 arquivos

sql/

  • 01_schema.sqlschemaJobs, etapas, recovery_log e as saídas das etapas

src/

  • scheduler_batch.tsCriação do job e disparo das etapas em ordem
  • agent_step.tsExecução com heartbeat e conclusão protegida por tentativa
  • supervisor_batch.tsReivindicação atômica, reinício e escalonamento
  • api_batch.tsEstado do job e trilha de recuperação
  • demo.tsdemoLote com o agente de juros morrendo na primeira tentativa
  • supervisor_batch.test.tstesteReinício, escalonamento, fencing, supervisores concorrentes e limiar contra PostgreSQL real

src/config_batch.ts / src/

  • pool_batch.tsAmbiente validado, pool e transactionExecute

Executar · com Docker

  1. ./docker.sh up# sobe PostgreSQL
  2. bun install# dependências
  3. bun run demo# roda o cenário
  4. bun run test# integração contra o serviço real

API de status: bun run api — GET /jobs/:id e GET /jobs/:id/recovery-log.

Requisitos
BunDocker
Sobe junto
PostgreSQL

Por que se relacionam

Teste rápido

Qual destes combina com Scheduler Agent Supervisor?

Próximo projeto · Dados & PersistênciaPersistent Data Structure
Esc

↑ ↓ navegarEnter abrir191 resultados